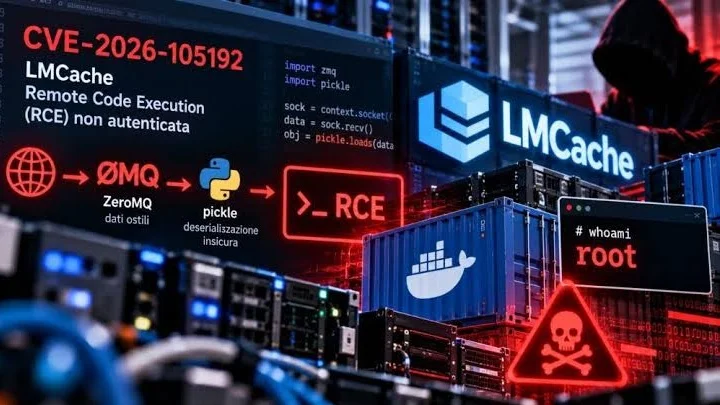
كشف باحثون أمنيون عن ثغرة أمنية بالغة الخطورة في مشروع LMCache مفتوح المصدر، وهو أحد المكونات المستخدمة على نطاق واسع لتسريع أداء خوادم النماذج اللغوية الكبيرة مثل vLLM، حيث تتيح الثغرة للمهاجمين تنفيذ تعليمات برمجية عن بُعد دون الحاجة إلى تسجيل الدخول أو امتلاك أي بيانات اعتماد مسبقة، في وقت لا تزال فيه جميع الإصدارات المتاحة عرضة للخطر دون توفر تحديث أمني يعالج المشكلة.
وتسلط هذه الثغرة الضوء على التحديات المتزايدة التي تواجهها البنية التحتية الخاصة بالذكاء الاصطناعي، والتي أصبحت هدفًا متناميًا للباحثين الأمنيين والمهاجمين على حد سواء، خاصة مع الانتشار السريع لمنصات الاستدلال الخاصة بالنماذج اللغوية الكبيرة داخل المؤسسات ومراكز البيانات الحديثة.
ثغرة تنفيذ أوامر عن بُعد دون مصادقة
بحسب ما كشفه فريق الأبحاث الأمنية في شركة JFrog، توجد الثغرة داخل وضع التشغيل متعدد العمليات (Multiprocess Mode) في LMCache، وهو نمط تشغيل يتيح تشغيل نظام التخزين المؤقت كخادم مستقل يمكن لعُقد المعالجة الخاصة بالنماذج اللغوية الوصول إليه عبر مكتبة المراسلة الشهيرة ZeroMQ.
وتكمن الخطورة في أن المهاجم لا يحتاج سوى إلى إرسال رسالة شبكية واحدة مصممة خصيصًا إلى الخادم المستهدف لكي يتمكن من تنفيذ أوامر برمجية بصلاحيات العملية المشغلة لـ LMCache.
ويحمل الخلل المعرف الأمني CVE-2026-105192، وقد حصل على تقييم خطورة بلغ 9.8 من 10 درجات، وهو تصنيف يضعه ضمن أعلى مستويات التهديدات السيبرانية المعروفة.
ورغم أن الخادم لا يكون مكشوفًا افتراضيًا للإنترنت، فإن الخطر يظهر عندما يضبط المشغلون الخدمة للاستماع إلى عناوين شبكية قابلة للوصول من أجهزة أخرى، وهو سيناريو شائع في البيئات المؤسسية التي تستخدم التخزين المؤقت المشترك بين عدة خوادم وعُقد ذكاء اصطناعي.
كيف تعمل الثغرة داخل LMCache؟
تعتمد المشكلة الأساسية على آلية معالجة الرسائل القادمة عبر ZeroMQ.
ففي الوضع المتأثر، لا يفرض الخادم أي مصادقة على الاتصالات الواردة، كما أنه يستخدم تنسيق Python المعروف باسم Pickle لفك بعض البيانات المستلمة.
ويُعرف Pickle منذ سنوات بأنه أداة خطيرة عند استخدامه مع بيانات غير موثوقة، لأنه لا يقتصر على استعادة البيانات فقط، بل يمكن أن يتسبب في تنفيذ تعليمات برمجية أثناء عملية فك التشفير أو تحليل المحتوى.
ووفقًا للتحليل الفني، يقوم الخادم بفك محتوى الرسالة الواردة قبل التحقق من نوعها أو تقييم درجة موثوقيتها، ما يسمح للمهاجم بتضمين تعليمات خبيثة داخل الرسالة نفسها ليتم تنفيذها مباشرة فور وصولها.
وتزداد المخاوف بسبب أن عملية التنفيذ تتم بالامتيازات نفسها الخاصة بخدمة LMCache. وفي الصور الرسمية للحاويات البرمجية الخاصة بالمشروع، تعمل الخدمة بصلاحيات المستخدم الجذر Root، وهو ما قد يمنح المهاجم سيطرة شبه كاملة على النظام المستهدف في حال نجاح الاستغلال.
نطاق التأثير وغياب الإصلاح الأمني
تشير البيانات المنشورة إلى أن الثغرة تؤثر على جميع إصدارات LMCache بدءًا من الإصدار 0.3.9 الذي صدر في أكتوبر 2025 وحتى الإصدار المستقر الأحدث 0.5.5.
كما أن الإصدارات التجريبية 0.5.6 وفرع التطوير الحالي ما زالت تحتوي على المشكلة نفسها.
وما يزيد من خطورة الوضع أن المطورين لم يطرحوا حتى الآن أي إصدار مصحح يعالج الثغرة بشكل رسمي، الأمر الذي يضع المؤسسات التي تعتمد على LMCache أمام تحدٍ أمني حقيقي.
وأوصت JFrog المشغلين بتجنب تعيين عنوان شبكي قابل للوصول لخادم LMCache متعدد العمليات، والإبقاء على الخدمة محصورة داخل الجهاز المحلي أو ضمن شبكات موثوقة ومعزولة.
كما أشارت الشركة إلى أن استخدام الجدران النارية يمكن أن يخفف من مخاطر الاستغلال، لكنه لا يقضي عليها بشكل كامل، لأن أي جهاز قادر على الوصول إلى المنفذ الشبكي سيظل قادرًا نظريًا على تنفيذ التعليمات البرمجية الخبيثة.
تقارير أمنية إضافية تثير المخاوف
لم تتوقف المخاوف عند هذه الثغرة فقط، إذ شهد مستودع المشروع على GitHub ظهور ستة بلاغات أمنية أخرى قبل يوم واحد من الكشف العلني عن CVE-2026-105192.
وتتضمن هذه البلاغات مزاعم بشأن إمكانية الوصول غير المصرح به إلى البيانات المخزنة مؤقتًا بين مستأجرين مختلفين داخل البيئة نفسها، فضلًا عن الإشارة إلى خدمات شبكية أخرى قادرة على تنفيذ أوامر دون الحاجة إلى مصادقة مسبقة.
ورغم أن هذه البلاغات لا تزال في مرحلة إثبات المفهوم ولم تُمنح أرقام CVE مستقلة، فإنها تعكس اتساع دائرة التدقيق الأمني المحيطة بالمشروع، خاصة بعد تزايد اعتماده في بيئات الذكاء الاصطناعي واسعة النطاق.
وفي تطور موازٍ، جرى مؤخرًا إصلاح ثغرة مرتبطة بمشروع vLLM نفسه تحمل المعرف CVE-2026-105756، وكانت تسمح للمهاجمين بالتسبب في تعطيل الخدمة عبر إرسال قيم مشوهة إلى نظام التخزين المؤقت، إلا أنها لم تكن تسمح بتنفيذ تعليمات برمجية كما هو الحال في ثغرة LMCache الحالية.
الذكاء الاصطناعي يواجه أخطاء متكررة في البنية الأساسية
يرى خبراء الأمن أن هذه الحادثة تعكس مشكلة أوسع داخل عدد من أطر تشغيل الذكاء الاصطناعي الحديثة، حيث ما زالت بعض المشاريع تعتمد على أساليب برمجية قديمة وخطيرة في التعامل مع البيانات غير الموثوقة.
ويعيد هذا الخلل إلى الأذهان مجموعة الثغرات التي كشف عنها باحثون أمنيون أواخر عام 2025 تحت اسم ShadowMQ، والتي استهدفت عدة منصات استدلال للذكاء الاصطناعي واعتمدت أيضًا على أخطاء مرتبطة بمعالجة الرسائل القادمة من الشبكات دون التحقق الكافي من مصداقيتها.
ومع توسع استخدام النماذج اللغوية الكبيرة داخل المؤسسات وتزايد الاعتماد على خوادم الاستدلال المشتركة، أصبح تأمين مكونات البنية التحتية مثل LMCache لا يقل أهمية عن حماية النماذج نفسها، إذ يمكن أن تتحول نقطة ضعف واحدة في طبقة التخزين المؤقت أو التراسل الشبكي إلى بوابة تمنح المهاجمين وصولًا مباشرًا إلى أنظمة الذكاء الاصطناعي ومواردها الحساسة.